
Миналата седмица Anthropic (компанията зад Claude) публикуваха интересно изследване за влиянието на големите езикови модели (LLM) върху трудовия пазар. Основният въпрос, който много хора задават след публикуването на изследването на Anthropic, е прост: ще вземе ли AI работата на хората? Много хора побързаха да споделят една конкретна графика – т.нар. паяжинна диаграма, в която:
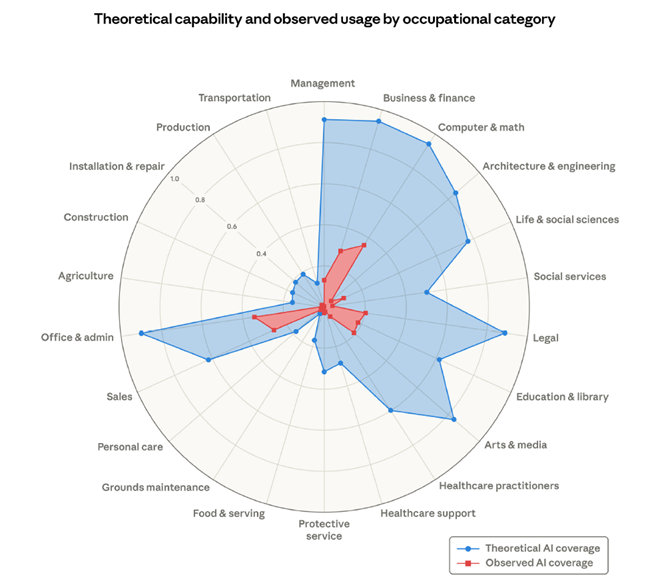
- синьото показва теоретичните възможности на AI да подпомага дадени професии
- червеното показва наблюдаваното реално използване.
Видях изказвания, как скоро ИИ ще замени хората в определени професии. Един интерпретира графиката като доказателство кои професии са застрашени от изчезване. Друг – като сравнение какви са възможностите на ИИ и какво е реалното състояние към момента.
Но преди да се отдадем на гръмки анализи и прогнози, първо трябва да се разбере какво точно показват стойностите в синьо и в червено и как са изчислени.
Нека ги разгледаме едно по едно.
Заб.: По-долу ще използвам термините AI (Artificial Intelligence) и ИИ (Изкуствен Интелект) като кратко означение за големи езикови модели LLM (Large Language Model), защото именно тях разглежда изследването.
Синьо – Theoretical Exposure
Как се изчислява показателят
Theoretical Exposure идва от по-ранното изследване GPTs are GPTs: An Early Look at the Labor Market Impact Potential of Large Language Models.
Основната идея е следната:
- За всяка професия се вземат задачите, описани в базата данни O*NET.
- За всяка задача се оценява дали LLM могат да помогнат да се намали времето за изпълнение на задачата с поне 50%.
- За задачите, за които LLM могат да намалят времето с поне 50% се присъжда тегло 1, на другите – 0
- Тези оценки се претеглят според колко време заема всяка задача в работата като процент от общото работно време.
Или представено с формула:
Theoretical exposure = сумата от дяловете на задачите, за които LLM могат да намалят времето за изпълнение с поне 50%.
За да стане по-ясно, нека да разгледаме долния пример.
Пример с финансов анализатор
За целите на примера, да приемем, че структура на работата на финансовия анализатор е следната (числата са условни):
| Задача | Дял от времето | LLM може да намали времето с повече от 50%? | Тегло | Дял × тегло |
| Събиране на данни | 15% | да | 1 | 15.00% |
| Обработка на данни | 20% | да | 1 | 20.00% |
| Анализ на данни | 20% | да | 1 | 20.00% |
| Изготвяне на отчет | 15% | да | 1 | 15.00% |
| Писане на доклад | 15% | да | 1 | 15.00% |
| Обсъждане на резултатите | 10% | не | 0 | 0.00% |
| Представяне на резултати | 5% | не | 0 | 0.00% |
| ОБЩО | 100% | 85.00% |
Общо theoretical exposure: 85%
Но внимание! Това не е 85% вероятност ИИ да замести хората в тази професия. Нито означава, че 85% от работата на финансовия анализатор в бъдеще ще я върши ИИ.
Theoretical Exposure не е отговор на въпроса „Ще вземе ли AI работата на хората?“. 85% Theoretical exposure означава, че 85% от работното време на финансовия анализатор е свързано със задачи, за които LLM биха могли да намалят времето за изпълнение с поне 50%.
Основни слабости на този модел
1. Оценява потенциал, а не реален ефект
Методът измерва дали AI може да помогне дадена задача да се свърши по-бързо, но не дали това реално спестява време или подобрява резултатите. Една задача може да бъде „LLM-capable“, но AI да помага минимално. Например: финансовият анализатор може да сваля всеки месец данни от сайта на БНБ. Това му отнема 2 минути на месец. Автоматизирането на тази задача ще спести 2 минути – колко съществено е това
2. Субективност при оценката на задачите
Оценките дали LLM могат да подпомагат дадена задача се базират на експертни преценки и анализ на моделите. Това неизбежно въвежда известна субективност
3. AI се свежда до LLM
В този модел AI практически означава LLM – системи за текст и код. Не се разглеждат други технологии като роботика, индустриална автоматизация, компютърно зрение
4. Структурата на O*NET задачите може да изкриви резултатите
Работата е разбита на много малки задачи. Ако AI може да подпомогне няколко от тях, theoretical exposure може да изглежда много висок, въпреки че цялата работа все още изисква човек да изразходи значително количество време, за да сглоби крайния резултат.
5. Оценява се количество, а не качество. Моделът дава тежест 1 на тези задачи, които могат да се свършат с 50% по-бързо с помощта на ИИ. Но дали това означава, че ще се запази качеството? А при други задачи е възможно те да не стават с 50% по-бързо, но пък да са извършени по-прецизно и подробно.
6. Използването на ИИ, може да създаде допълнителна работа. Дори когато LLM ускорява дадена задача, това не означава автоматично спестяване на време в крайния процес. При много аналитични дейности се налага допълнителна проверка, корекция и валидиране на резултата. Повтаряне и коригиране на промптовете докато се постигне желания резултат.
Червено – Observed Exposure
Как се изчислява показателят
Observed Exposure е предложен в изследването на Anthropic и се опитва да измери от задачите, които LLM могат да изпълняват, кои реално се наблюдават в Claude разговорите.
Процесът е:
- Анализират се заявките към Claude.
- Те се класифицират по тип задача и по начин на използване – дали AI подпомага човека, автоматизира по-голяма част от задачата или изобщо не се използва по съществен начин.
- Тези задачи се свързват с O*NET професии.
- Задачите се претеглят според времето, което заемат.
Разликата е, че тук се добавя фактор:
-
- Automation (по-голяма степен на автоматизация) = 1.0
- Augmentation (подпомагане на човека, но не пълна автоматизация) = 0.5
- Няма използване на ИИ = 0.0
Да видим как се изчислява този показател в примера с финансовия анализатор (отново данните са фиктивни)
Пример – финансов анализатор
| Задача | Дял от времето | Тип използване | Тегло | Дял × тегло |
| Събиране на данни | 15% | augmentation | 0.5 | 7.50% |
| Обработка на данни | 20% | augmentation | 0.5 | 10.00% |
| Анализ на данни | 20% | augmentation | 0.5 | 10.00% |
| Изготвяне на отчет | 15% | automation | 1.0 | 15.00% |
| Писане на доклад | 15% | augmentation | 0.5 | 7.50% |
| Обсъждане на резултатите | 10% | няма | 0.0 | 0.00% |
| Представяне на резултати | 5% | няма | 0.0 | 0.00% |
| ОБЩО | 100% | 50.00% |
Observed exposure: 50%
Основни слабости на този модел
- Измерва запитвания към Claude, не автоматизация
Observed exposure се базира на разговори с Claude, което означава, че измерва използването на инструмента, а не реалната автоматизация на задачи.
- Augmentation и Automation се оценяват твърде високо
Augmentation получава тегло 0.5, което предполага значителен ефект. В реалността AI помощта често може да спестява много по-малко време. По същия начин, задачите, оценени като „automation” получават тегло 1, дори и ефектът от тази автоматизация да е само 20 или 30% спестено време.
- API използването се интерпретира като автоматизация
Интеграция чрез API се брои като automation, въпреки че може да представлява само малка част от по-голям работен процес. Например, чрез API да се извличат данните за валутните курсове от сайта на БНБ, но после ръчно да се обработват.
- Непредставителна извадка
Observed exposure се базира на данни от един AI инструмент – Claude. Това може да създаде изкривяване, защото различните професии използват различни инструменти. Освен това различните модели имат различни силни и слаби страни. Нещо, което потребителите правят с Claude, може да изглежда различно, ако използват ChatGPT, Gemini, Copilot или вътрешен корпоративен модел.
- Контекстът на използване не е ясен
Заявките към AI могат да бъдат:
- реална работа
- обучение
- експерименти
- лични проекти.
Моделът трудно може да ги различи. Не е ясно дали запитването „изчисли печалбата по продукт на база данни от приложения файл“ е от студент, който решава домашна работа или от реален финансов анализатор.
- Не се измерва икономическият ефект
От факта, че AI се използва за дадена задача, не следва автоматично, че това спестява време или пари. Всъщност голяма част от задачите, които подлежат на автоматизация (или аугментация) са такива с малка добавена стойност – извличане и обработка на данни, изготвяне на отчети и презентации. Истинската стойност идва от онези 10-15 процента от времето на анализаторите, в които те обсъждат резултатите или правят допълнителни проучвания, за да открият причините, проверяват различните варианти за оползотворяване на възможностите.
Освен това, от икономическа гледна точка, ускоряването на задача не е равнозначно на ръст на производителността. Истинският ефект зависи от това дали спестеното време се превръща в повече или по-качествен краен продукт.
Какво всъщност измерват тези метрики
Важно е да се подчертае:
Нито theoretical exposure, нито observed exposure измерват:
- използване на AI вместо хора
- замяна на работни места
- икономически ефект
- Ще вземе ли AI работата на хората
И двете метрики правят опит да измерят Exposure, т.е. степента, в която задачите в дадена професия могат да бъдат подпомогнати или ускорени от LLM.
Дефинирана така, Exposure не е същото като замяна. Дори висока exposure стойност не означава автоматично, че търсенето на хора в тази професия ще намалее. Напълно възможно е AI да увеличи производителността и да разшири обхвата на работата, вместо да намали нуждата от труд. Казано по друг начин – финансови анализатори пак ще има, но ще правят повече от същото.
А може да правят и нещо друго. И двете метрики пропускат именно това – има ли работа, която в момента не се извършва, но може да бъде свършена, когато се използва ИИ?
Например финансовият анализатор може да използва AI, за да анализира стотици годишни отчети, статии, прес съобщения, публикации в социалните мрежи, свързани с бизнеса на компанията и да генерира десетки сценарии във финансов модел. По този начин да предостави по-детайлна и полезна информация на ръководството на фирмата. Този тип работа рядко се извършва в момента, защото е твърде трудоемка. Подобни ефекти изобщо не се улавят от метриките за exposure.
Ха-ха, тези са си оплескали анализа. Спокоен съм
Считам, че няма място за подобно високомерие. Да, има някои основания да оспорим резултатите от проучването на Anthropic. Но то показва нещо много важно – хората вече използват AI в работата си. Дали с учебна цел, дали експериментират или вече извличат реална полза – това е второстепенно. По-важното е, че се натрупва опит. Потребителите започват да разбират кога AI помага, кога не, как трябва да бъде използван и как не. Този процес на учене може да се окаже много по-важен от текущите измервания на ефективност. Затова изводът не трябва да бъде, че можем спокойно да игнорираме AI, защото анализът има слабости. По-скоро обратното – именно защото технологията вече се използва, има смисъл активно да търсим начини да я разбираме и използваме по-добре.
Заключение: Ще вземе ли AI работата на хората?
Изследването на Anthropic е интересен опит да се измери как AI започва да се използва в различни професии. Паяжинната графика, която често се цитира, наистина показва две важни неща:
- къде LLM биха могли да помагат
- къде вече се използват.
Но тя не трябва да се интерпретира като карта на автоматизацията или на риска AI да вземе работата на хората.
По-скоро това е ранен индикатор за това как нов инструмент започва да се интегрира в работата – и както често се случва с новите технологии, реалното влияние върху икономиката вероятно ще бъде много по-сложно от една единствена графика.
Докладът на Anthropic разглежда и един друг интересен въпрос – отнема ли вече работни места изкуственият интелект. Как точно анализират това и доколко добре се справят, може да прочетете в тази статия.